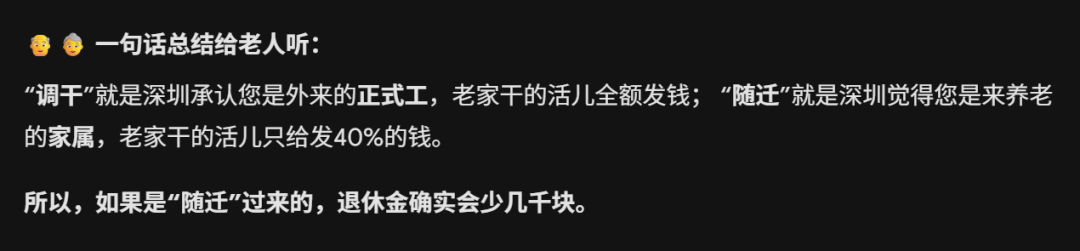
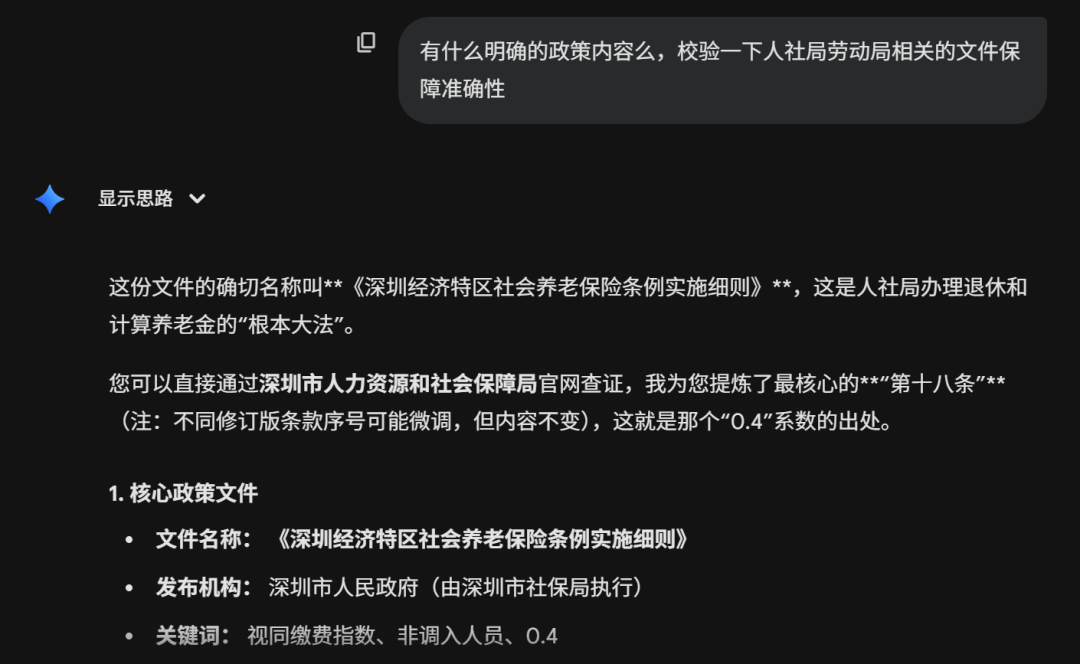
昨晚跟朋友闲聊,话题扯得有点远,从“现在的 AI 到底能不能信”一路聊到了深圳户口的社保待遇。刚好手边开着电脑,我就顺手打开 Gemini 3 Pro 帮他查了一个很具体的业务问题:“听说深圳随迁的户口跟调干的户口退休待遇差很多,是真的么?有没有明确政策?我是小白,请用最直白的话告诉我。”“非经调入而在本市户籍期间或者在本市居住期间获得视同缴费年限的参保人,其视同缴费年限的月缴费指数按 0.4 计算。”
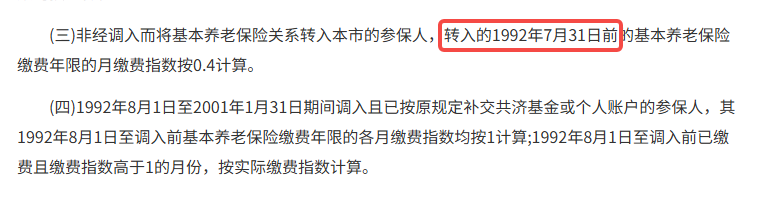
看到“0.4”这个数字,我确实愣了一下,0.4 这意味着退休金不是打折,而是直接打骨折了,但我还是把结论给朋友看了一眼,他回复说:但做我们这行(AI 产品运营)的,有个职业病,就是对通用大模型总有一种天然的不信任;尤其是在处理法律、医疗、政策这种严谨问题时,AI 喜欢“一本正经地胡说八道”,这毛病见得多了,为了验证,我特意去翻了政策原文:就是这一步“多此一举”的验证,让我抓住了通用 AI 目前最大的一个隐患:我在繁杂的政策原文件里,确实找到了那个“0.4”,但在它前面,明明白白写着一个被 AI 在总结时“吞掉”的边界条件:“转入的 1992年7月31日前 的基本养老保险缴费年限的月缴费指数按0.4计算。”
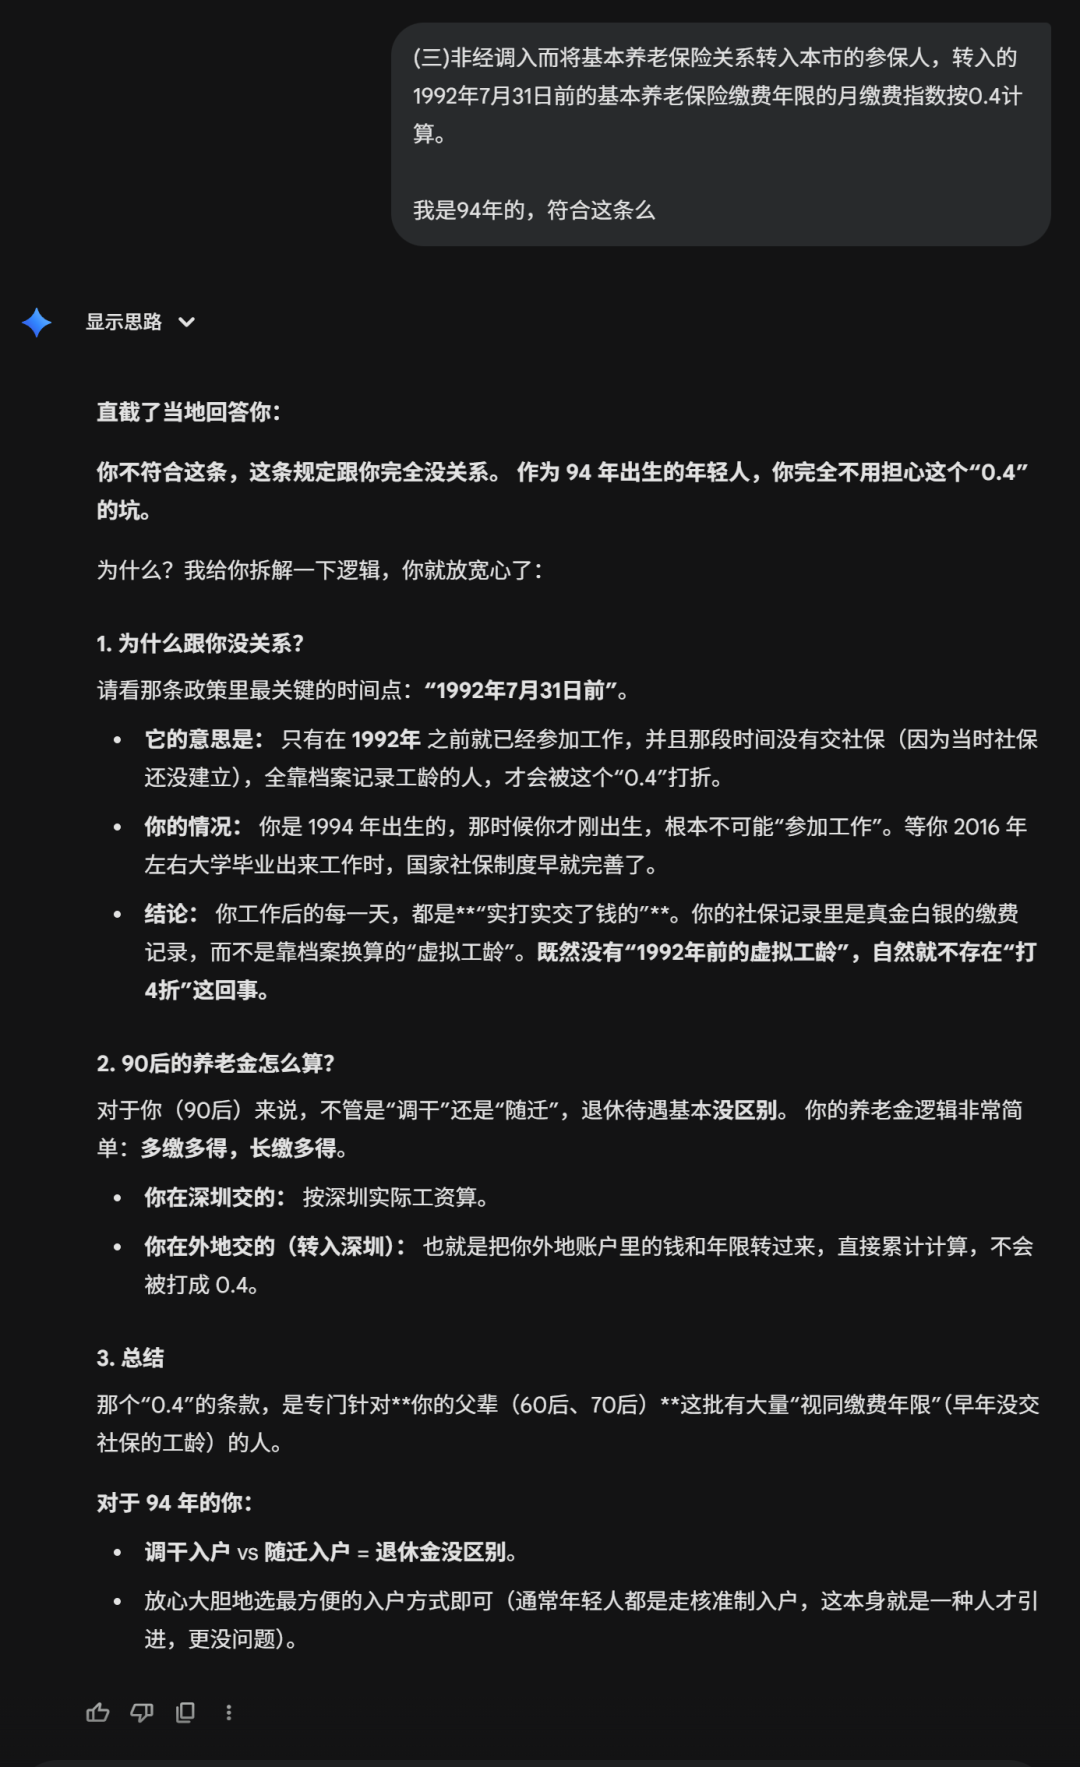
我是 94 年出生的,这意味着,AI 刚才告诉我们“按 0.4 计算”的结论,对我们这代人来说,完全是无效的。我又把这条政策原文和补充信息(我是94年的)丢给 AI,它立马改口:如果我刚才懒了一下,没去翻原文呢?如果是一个完全不懂技术、对 AI 盲目信任的普通用户呢?可能就会基于一个完全错误的“0.4”结论,做出了关乎他后半生福利的错误决策;这时候,我感觉清晰的看到了,这是目前通用 AI 落地应用中一个巨大的、被忽视的黑洞。为什么现在的 RAG(检索增强生成)技术会犯这种低级错误?
理论上 AI 就像一个还没毕业的实习生。为了让你觉得它懂得多、说话好听,它在做总结时,会下意识地把那些它认为“啰嗦”的定语给优化掉;它把“1992年前”这个关键的时间特指,粗暴地概括成了“所有情况”的通解。一个真正负责任的人类顾问,听到我问这个问题,脑子里一定会转个弯:“政策里提到了 1992 年,我得先问问客户是哪年生的。如果是 90 后,这事儿就跟他没关系。”但 AI 没有这个“多想一步”的意识,它只管检索文本,不管“这个文本跟你的关系”。在问关键决策(钱、病、法)时,永远不要只听 AI 的“总结”,要追加一句:“在这个结论生效前,有没有什么前提条件?比如时间、身份、年龄的限制?确实,指望一个不懂社保政策的人,能像逻辑学家一样,预判出“可能存在年份限制”,然后在 Prompt 里主动加上“我是90后”,这根本不现实。这就是普通用户的死循环:因为不懂,所以不知道该问什么;因为没问,AI 就默认这不重要;结果就是——你在毫不知情的情况下,直接把你坑了。所以,回到我们这帮做 AI 运营和产品的人身上,我们真正该干的活是什么?
我们不应该教育用户成为“提问大师”,而是要把这些复杂的“限制条件(1992年)、背景上下文(用户画像)、业务逻辑判断(SOP)”,全部封装在产品的黑盒内部;让用户像“傻瓜”一样提问,还能得到专家级的回答。在这个 Case 里,如果是一个“垂直于社保领域的 AI Agent”,它绝对不应该直接回答 0.4,它应该内置了一套严密的思维链:- 触发边界:知识库显示该条款有“1992年”的时间限制。
- 主动反问/自动调取:“请问您的出生年份/工作年份?”
- 精准输出:“因为您是 94 年出生,不涉及 1992 年前工龄,所以该限制对您无效。”
这才是我们这帮人存在的意义,也是垂直领域 AI 不可被替代的核心壁垒。
SOURCE / 文章来源
林万劲 · 林万劲的AI思考 · 2026.01.09
在公众号阅读原文 ↗