不是因为没东西可想,恰恰相反:最近看到很多场景,看到很多具体问题反复出现。它们最后指向的,其实不是“模型又强了多少”,而是一个更朴素的问题:
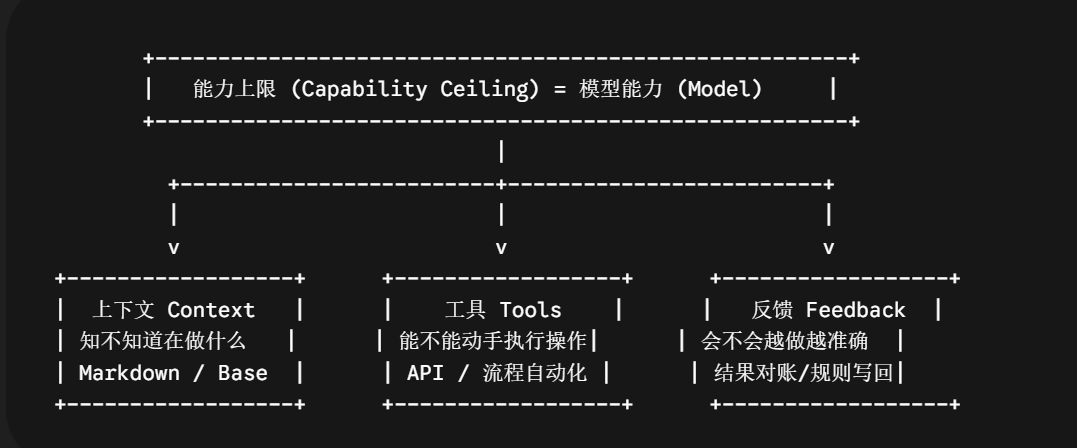
怎样让 AI 从一次次聊天,变成真正参与工作的系统?最后发现,模型能力当然重要,但它更像能力上限。
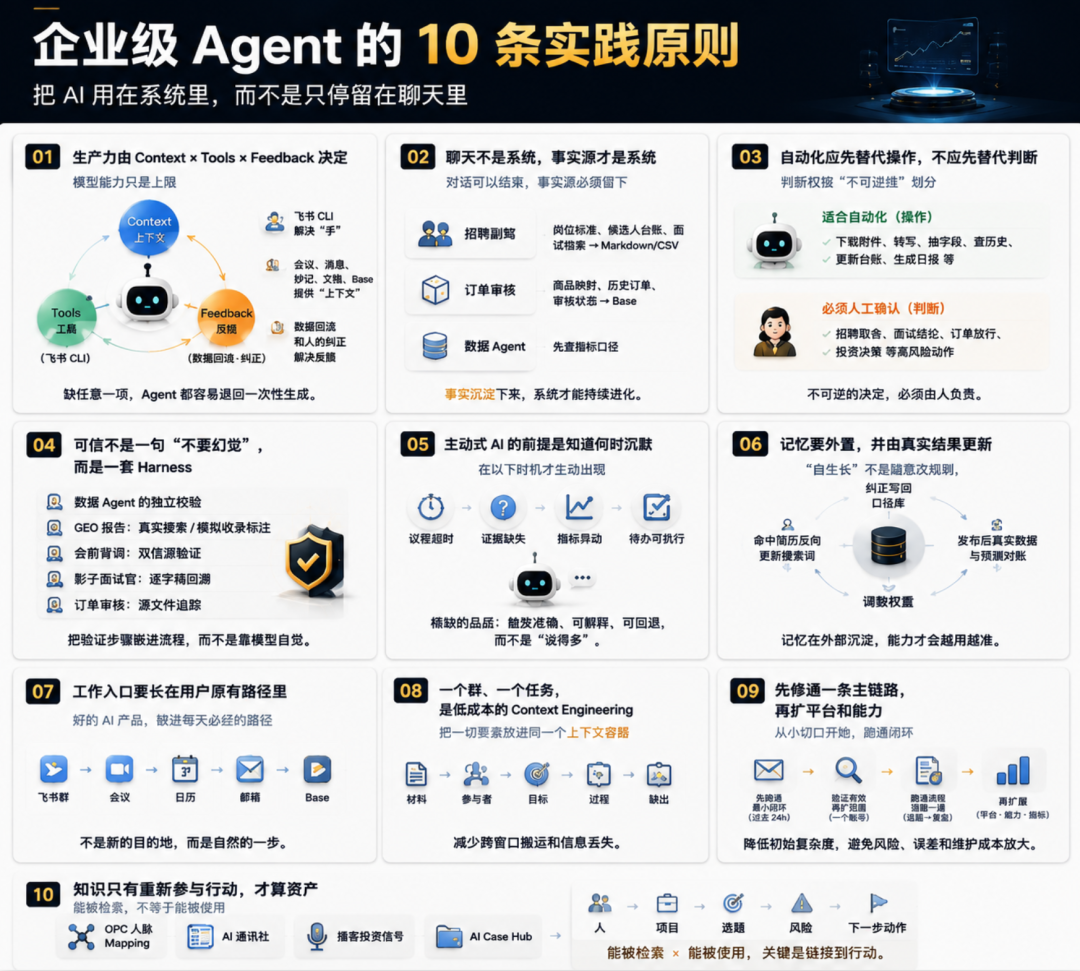
真正决定 AI 能不能进入工作流的,是另外三件事:工具决定它能不能动手,上下文决定它知不知道自己在做什么,反馈决定它会不会越做越准。少了任何一项,Agent 都很容易退回“一次性生成”。我把最近最核心的十个观察整理在这里。它们未必新鲜,但足够具体:关于上下文、工具、反馈、事实源、人的判断权,以及一个 Agent 到底应该在什么时候开口、什么时候沉默。准备好了,可以往下看,每个点都值得停留和思考,预计需要5分钟;1. 聊天不是系统,事实源才是
招聘副驾需要岗位标准、候选人台账和面试档案;订单审核需要商品映射、历史订单和审核状态;数据 Agent 首先要知道指标口径。对话只是入口,Markdown、CSV、Base、文档库才是系统。2. 自动化先替代操作,不要急着替代判断
下载附件、转写录音、抽取字段、查询历史、更新台账、生成日报,这些都适合交给 AI。但招聘取舍、面试结论、订单放行、投资决策,仍然应该由人确认。不要按岗位划分人和 AI 的边界,而要按风险和后果划分。3. 可信不是“别幻觉”,而是把验证写进流程
真正有效的方式,是给 Agent 加一套 Harness。数据 Agent 做独立校验;研究报告标注真实搜索和模拟推断;会前背调要求双信源;影子面试官可以回到逐字稿;订单审核必须能追到源文件。4. 主动式 AI 的前提,是知道什么时候沉默
好的异常预警,也不是把所有波动都推过来,而是在指标真的异常、且有人能采取行动时出现。企业级 Agent 最稀缺的能力,不是“说得多”。5. 记忆必须外置,而且要被真实结果更新
更可靠的做法是:把人的纠正写回口径库;把命中的简历反向更新搜索词;把发布后的真实数据和发布前预测对账,再调整权重。它应该是一套能被检查、被修正、被结果验证的外部资产。6. AI 应该长在用户本来的路径里
影子面试官最初做成独立网页,后来发现,用户开会时根本不会切出去。很多案例最后都回到飞书群、会议、日历、邮箱和 Base。7. 一个群、一个任务,就是低成本的 Context Engineering
把材料、参与者、目标、过程和输出放进同一个上下文容器里,往往比复杂的 Agent 架构更有效。一个群对应一个项目,一个任务对应一套资料和一条主线。这样做的价值很朴素:少切换窗口,少搬运信息,少丢失上下文。很多协作问题,本质上不是能力不够,而是上下文太碎。8. 先跑通一条主链路,再谈平台化
订单审核先验证过去 24 小时的邮件;内容监测先盯住一个账号;媒体引擎先跑通“选题—发布—复盘”。一开始就追求全平台、全自动、全指标,往往会同时放大维护成本、风控问题和错误率。9. 知识只有重新参与行动,才算资产
真正的知识资产,要能重新连接到人、项目、选题、风险和下一步动作。人脉 Mapping 不是通讯录;案例库不是文件夹;投资信号也不是收藏夹。10. AI 的核心,不是替人思考,而是让组织少浪费思考
而是帮团队少找一次资料,少开一次无效会,少漏一个风险,少重复一次已经做过的判断。模型越来越强之后,真正拉开差距的,可能不再是谁先接入了最新模型。而是谁先把上下文沉淀下来,把工具接进流程,把反馈变成系统。上下文、工具和 反馈,决定 AI 最终能产生多少真实生产力。
SOURCE / 文章来源
林万劲 · 林万劲的AI思考 · 2026.08.06
在公众号阅读原文 ↗